Data Science & Analyse Prédictive

La donnée est souvent présentée comme le nouveau pétrole, mais en Afrique, le défi n'est pas tant son absence que sa dispersion, son hétérogénéité et son sous-exploitation. Les données climatiques existent dans des archives météorologiques peu numérisées ; les données agricoles sont éparpillées entre coopératives, ministères et ONG sans format commun ; les données économiques locales sont souvent estimées plutôt que mesurées. La mission de notre pôle Data Science est de collecter, nettoyer, structurer et valoriser ces données dispersées pour en faire des outils de décision fiables.
Notre travail commence presque toujours par une phase d'ingénierie de données : identifier les sources pertinentes (satellites, capteurs IoT, enquêtes terrain, bases administratives, données ouvertes internationales), construire des pipelines robustes de collecte et de nettoyage, et harmoniser des formats hétérogènes en bases de données exploitables. Cette étape, peu visible mais essentielle, représente souvent plus de la moitié du temps investi dans un projet d'analyse prédictive — et c'est précisément l'étape que beaucoup de prestataires négligent, produisant des modèles brillants sur le papier mais inutilisables en pratique faute de données fiables en entrée.
Une fois les données consolidées, nous développons des modèles prédictifs adaptés à chaque cas d'usage : prévision de rendements agricoles en fonction de variables climatiques et pédologiques, anticipation de risques sanitaires à partir de données épidémiologiques et environnementales, modélisation de la demande énergétique dans des zones en électrification progressive, ou encore scoring de risque financier pour des populations sans historique bancaire classique. Nous combinons des techniques statistiques éprouvées avec des approches de machine learning plus récentes, en choisissant toujours la méthode la plus adaptée à la taille et à la qualité des données disponibles plutôt que la plus sophistiquée sur le papier.

La restitution des résultats est un axe auquel nous accordons une attention toute particulière. Un modèle prédictif, aussi précis soit-il, n'a de valeur que s'il est compris et utilisé par les décideurs auxquels il s'adresse — qu'il s'agisse d'un responsable de coopérative agricole, d'un cadre ministériel ou d'un chef d'entreprise. Nous construisons donc systématiquement des tableaux de bord visuels, des rapports synthétiques et des alertes automatisées qui traduisent des analyses statistiques complexes en informations directement actionnables, sans jargon technique inutile.
Notre plateforme GeoClimate Explorer illustre bien cette approche intégrée : elle combine des données satellites, des modèles climatiques et des algorithmes d'IA pour simuler différents scénarios hydriques et de rendement agricole sous divers futurs climatiques possibles. Un exploitant agricole ou un planificateur territorial peut ainsi visualiser l'impact probable de différentes stratégies (choix de cultures, calendrier d'irrigation, infrastructures de stockage d'eau) avant de s'engager dans des investissements coûteux et difficiles à réviser. De même, AGROSuite IA offre aux coopératives agricoles un tableau de bord complet de pilotage — qualité des récoltes, logistique de transport, prédiction de rendements — avec des API permettant l'intégration à d'autres systèmes déjà en place.
Nous croyons que l'analyse prédictive appliquée à l'Afrique ne doit pas se contenter d'importer des modèles conçus pour des contextes agricoles, climatiques ou économiques différents. Chaque modèle que nous développons est calibré sur des données locales, validé par des experts du secteur concerné, et testé en conditions réelles avant tout déploiement. C'est cette rigueur méthodologique, combinée à une compréhension fine du contexte local, qui permet à nos clients de prendre des décisions fondées sur des preuves plutôt que sur des intuitions, dans des environnements où chaque ressource — eau, capital, temps — est précieuse et ne peut être gaspillée sur la base de prévisions approximatives.
Nous investissons également dans la pédagogie autour de la donnée : former les équipes de nos clients à lire correctement un intervalle de confiance, à comprendre les limites intrinsèques d'un modèle prédictif, et à éviter le piège fréquent de la sur-confiance dans un chiffre unique sorti d'un algorithme. Un bon modèle de data science n'élimine jamais totalement l'incertitude ; il la quantifie et la rend gérable. C'est cette culture de la donnée, autant que les modèles eux-mêmes, que nous cherchons à transmettre durablement à chaque organisation avec laquelle nous travaillons, afin qu'elle puisse continuer à exploiter intelligemment ses données bien après la fin de notre accompagnement direct.
Nous accordons enfin une grande importance à la qualité et à la gouvernance des données dans la durée : mise en place de processus de mise à jour régulière, contrôles de cohérence automatisés, et documentation claire de la provenance de chaque source utilisée. Une base de données brillante au moment de sa livraison mais livrée sans processus de maintenance se dégrade rapidement et perd toute utilité opérationnelle en quelques mois ; nous concevons donc systématiquement des mécanismes de gouvernance pérennes dès la conception initiale du projet.
Projets réalisés dans ce domaine
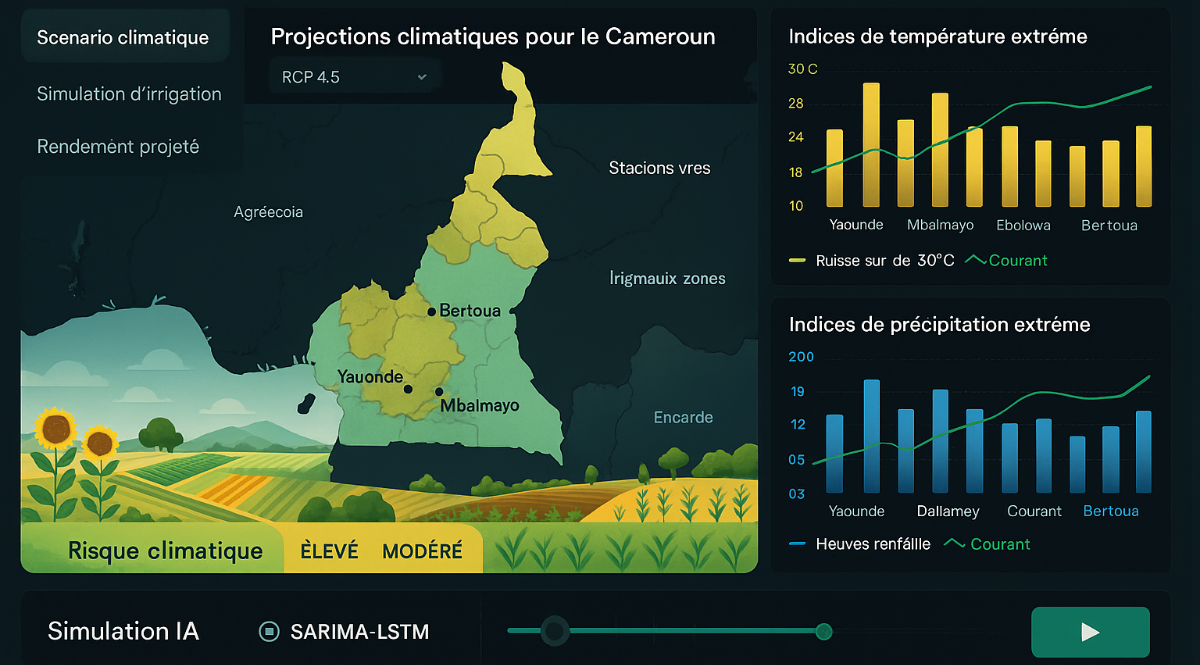
GeoClimate Explorer
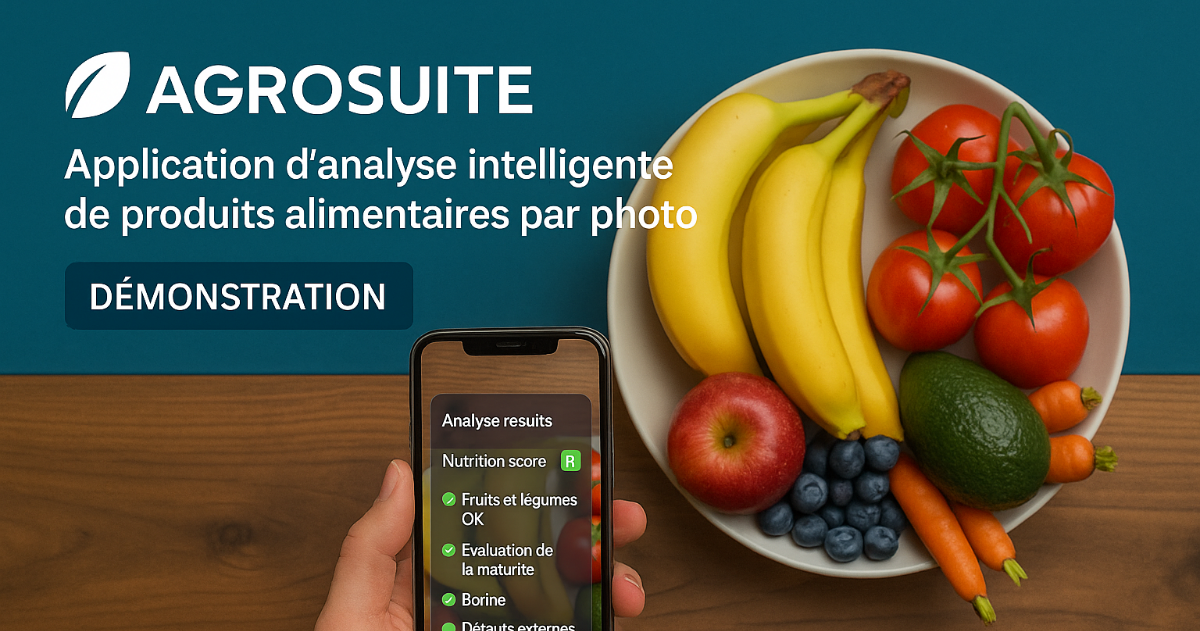
AGROSuite IA